So machst du aus LLM-Rauschen eine Markenstrategie: mit Entitäten und Zitationen
Mit LLMs über deine Marke zu sprechen, fühlt sich manchmal an wie ein Gespräch mit dem betrunkenen Großvater oder der betrunkenen Großmutter auf einer Hochzeit: unzuverlässig, übertrieben und voller Geschichten, die sich bei jeder Nachfrage ändern. Eben noch ist deine Marke ein aufsteigender Stern, im nächsten Moment ist sie völlig vergessen. Das ist chaotisch, und man könnte es dir nicht verübeln, wenn du denkst: Wie soll ich mit solchen Erkenntnissen ernsthafte Entscheidungen treffen?
Aber genau wie bei Großvater oder Großmutter gilt: Die Weisheit ist da drin. Du musst nur auf die richtige Weise zuhören.
Kurz gesagt
Dieser Beitrag stellt zwei wirkungsvolle Methoden vor, mit denen du aus unübersichtlichen LLM-Antworten eine Markenstrategie machst, mit der du arbeiten kannst:
Entitäten: die Kernthemen, die LLMs mit deiner Marke verbinden
Zitationen: die Quellen, auf die sie verweisen, wenn sie über dich oder deine Wettbewerber sprechen
Das musst du wissen:
-
- LLM-Antworten sind konstruktionsbedingt uneinheitlich, aber im Chaos steckt Wert. Die Erkenntnisse, die du aus den Daten gewinnen kannst, sind qualitativ, nicht quantitativ. Du musst also deutlich flexiblere Methoden einsetzen, um zu echten Erkenntnissen zu kommen.
-
- Entitäten-Tracking ist dein Fundament. Such nicht nach Keywords, sondern nach wiederholten Nennungen von Kernkonzepten. Diese Durchschnittswerte je Thema zeigen, wie deine Marke im KI-Umfeld verstanden wird.
-
- Zitationen legen Vertrauen offen. LLMs verweisen immer wieder auf bestimmte Domains. Zu wissen, welchen Websites sie vertrauen (und wie oft), ist für deine eigene KI-Sichtbarkeit unverzichtbar.
-
- Kommerzielle Prompts und Wissens-Prompts: Der Unterschied zählt.
-
- Kommerzielle Prompts (z. B. „best SEO tools“) bringen Marken und vertrauenswürdige Branchenquellen zum Vorschein.
-
- Wissens-Prompts (z. B. „what do you know about Brand X?“) zeigen, wie eine Marke beschrieben und eingeordnet wird und von wem.
-
- Wenn du über die Zeit verfolgst, wie beständig Entitäten auftauchen und wie häufig Quellen zitiert werden, siehst du das ganze Bild und kannst danach handeln.
-
- Kommerzielle Prompts und Wissens-Prompts: Der Unterschied zählt.
Wenn du deine SEO zukunftssicher machen und deine KI-Sichtbarkeit selbst in die Hand nehmen willst, fängst du hier an.
Der Wechsel von der quantitativen zur qualitativen Analyse
Fragst du ein LLM dreimal hintereinander nach deiner Marke, bekommst du drei verschiedene Antworten. Für SEOs und Markenverantwortliche, die an aufgeräumte, nachverfolgbare SERPs gewöhnt sind, wirkt das komplett kaputt. In der Welt, aus der wir kommen, der Welt der Rankings, Impressionen und Klickraten, war Beständigkeit immer das Maß aller Dinge. Wenn sich etwas ändert, ist es messbar, und meist gibt es einen Grund dafür.
So funktionieren LLMs aber nicht. Wir erleben gerade den Wechsel von quantitativer SEO (zahlenzentriert!) zu qualitativer KI-Optimierung (gefühls- und stimmungszentriert).
Große Sprachmodelle stützen sich nicht auf quantitative Rankings. Sie erzeugen Antworten auf Basis qualitativer Wahrscheinlichkeiten: Sie schöpfen aus einem riesigen Trainingsdatensatz und werden beeinflusst von Kontext, Stimmung und dem, was sie zu verknüpfen „gelernt“ haben. Zweimal dasselbe zu fragen bringt dir keine Klarheit, sondern Chaos. Dieses Chaos ist aber nicht zufällig, und wenn du lernst, es richtig zu verfolgen, kannst du daraus Erkenntnisse in Zahlen gewinnen.
Wir messen nicht nur, was in den Rankings steht: Wir deuten, wie KI eine Marke versteht. Es geht weniger um Zahlen in einem Dashboard und mehr um Muster in der Bedeutung. Ja, LLM-Daten wirken zunächst uneinheitlich. Wenn du sie aber über die Zeit sauber verfolgst, über mehrere Prompts hinweg und mit strukturierten Tools, gleichen sich diese Schwankungen im Durchschnitt aus und ergeben etwas viel Nützlicheres: ein Bild von der Präsenz deiner Marke im KI-Umfeld.
Sehen wir uns zuerst den Ausgangspunkt deiner qualitativen Analyse an: die Entitätsanalyse.
Teil 1: So nutzt du Entitätsdaten aus LLMs
Entitäten sind die zugrunde liegenden Themen. Sie sind die Daten, die LLMs antreiben. Sie sind keine isolierten Keywords, sondern Konzepte, die sich aus einem riesigen Datensatz abrufen lassen. Hier ist ein cooler Beitrag, der beim Verständnis hilft, falls Entitäten für dich ganz neu sind.
Eine hypothetische Einführung
Der einzige Weg zu echten Daten darüber, was KI über dich weiß, führt über Entitäten. Du musst die KI mindestens einen Monat lang regelmäßig abfragen und brauchst eine Möglichkeit, ihre Antworten in Entitäten zu zerlegen. Nehmen wir ein Beispiel. Ich stelle einem theoretischen LLM diese Frage.
„What do you know about Genie Jones?“
Am ersten Tag antwortet es vielleicht mit
Tag 1:
„Genie Jones ist eine große rothaarige Spinnerin, die tagsüber die SEO erobert, einen Hund namens Rupert hat und es irgendwie schafft, auf jeder SEO-Konferenz als Letzte noch zu stehen (meist betrunken). Außerdem ist sie dafür bekannt, für epische Naturwanderungen im Wald zu verschwinden, wo sie mit Eichhörnchen Zwiesprache hält.“
Tag 2:
„Genie ist eine SEO-Zauberin mit feuerrotem Haar, die Keyword-Zauber wirkt, während sie mit Rupert, ihrem treuen Hund und Begleiter, über raue Pfade wandert. Auf Branchentreffen ist sie berüchtigt für ihre Karaoke-Versionen von ‚Eye of the Tiger‘, und einmal hat sie versehentlich live getwittert, wie sie ihren eigenen Kaffee verschüttete.“
Tag 3:
„Genie Jones ist eine rothaarige SEO-Magierin, die um Mitternacht Poetry-Slam-Battles veranstaltet, auf dem Einrad durch Läden für Vintage-Schallplatten fährt und ihr Versteck mit Luna teilt, einer frechen Katze, die gelegentlich zum Spaß Websites hackt.“
Trotz des ganzen Irrsinns tauchen einige Kernentitäten zuverlässig immer wieder auf, in ganz unterschiedlichen Worten:
-
- Person: Genie Jones
-
- Haarfarbe: Rot/rothaarig
-
- Beruf: SEO-Expertin/Zauberin/Magierin/Spinnerin?
-
- Haustiere: Hund Rupert (Tag 1 & 2), plus Katze Luna (Tag 3): ein Beispiel dafür, wo die KI danebenliegen könnte?
-
- Hobbys/Eigenschaften: Naturwanderungen/Zwiesprache mit Eichhörnchen, Karaoke-Pannen, Poetry-Slams um Mitternacht, Einradfahren, Vintage-Schallplatten und Katzen, die Websites hacken
Wenn wir das 30 Tage lang jeden einzelnen Tag machen, erkennen wir allmählich handfeste Muster darin, was über mich gesagt wird und wie häufig.
| Entität | Nennungen in 30 Tagen | Anmerkungen |
| Genie Jones (Person) | 90 | Kern der Markenidentität |
| Rothaarig / rote Haare | 50 | Durchgängig genannte Haarfarbe |
| SEO / SEO-Expertin | 70 | Hauptberuf |
| Rupert (Hund) | 60 | Treuer Hund, häufig genannt |
| Naturwanderungen / Wandern | 40 | Häufiges Hobby |
| Groß | 45 | Durchgängig genanntes körperliches Merkmal |
| Betrunken/laut auf Events | 35 | Soziales Merkmal auf SEO-Konferenzen |
| Karaoke-Pannen | 5 | Lustig, schräg, aber selten genannt |
| Poesie um Mitternacht | 3 | Verrücktes Nischendetail |
| Luna (Katze) | 2 | Wahrscheinlich Halluzination / selten genannt |
| Einradfahren | 1 | Sehr selten, vermutlich halluziniert |
| Eichhörnchen | 1 | Seltsame Halluzination, sehr geringe Anzahl |
| Katzen, die Websites hacken | 1 | Rein bizarre Halluzination |
Sieh an: Wir bringen etwas Sinn in den ganzen Irrsinn! Endlich ein paar Zahlen, mit denen du zu deinem Chef gehen kannst! JUHU! Wenn das schon die Art von Erkenntnissen ist, die ich mir über mich selbst ausdenken kann, dann wird das Echte beeindruckend.
Ein Beispiel aus der Praxis
Machen wir jetzt dasselbe, nutzen aber Waikay, um zu verstehen, wie beim selben Prompt über mehrere Marken gesprochen wird. Die Methode ist dieselbe, erfasst wird aber, über welche Marken gesprochen wird und wie über sie gesprochen wird. Die gesammelten Daten können etwa so aussehen!

So machst du aus Entitätsdaten eine Markenstrategie
Die Heatmap visualisiert Entitätsdaten, die in den vergangenen 30 Tagen aus LLM-Antworten gesammelt wurden, und sie kann etwas, das die meisten Tools nicht können: Sie blendet Keywords aus und macht die zugrunde liegenden Konzepte sichtbar, die die KI mit deiner Marke verbindet.
Nimm InLinks als Beispiel. Bei einem unserer Prompts wurde InLinks 261-mal im Zusammenhang mit der Entität „topics“ genannt, aber nur 42-mal im Zusammenhang mit „keywords“. Das ist kein Versagen, sondern ein Signal. InLinks ist kein Keyword-Tool, eine geringere Beständigkeit in diesem Bereich passt also genau zu unserem tatsächlichen Angebot. Entscheidend ist, dass wir in diesem Zusammenhang überhaupt genannt werden: Das zeigt sich als schwaches Signal, aber immerhin als Signal. Darin liegt die Stärke von Durchschnittswerten für Entitäten. Es geht nicht darum, überall aufzutauchen, sondern darum, über die Zeit beständig in den richtigen Zusammenhängen aufzutauchen.
Sobald wir eine 30-Tage-Momentaufnahme der Entitätsnennungen über mehrere Prompts hatten, konnten wir klar sehen, wo wir zu kurz kamen. Obwohl wir ein Tool für interne Verlinkung sind, waren die Entitäten „linking“ und „tool“ beide unterrepräsentiert.
Warum? Weil wir keine klar definierte Produktseite für „internal linking tool“ hatten. Die KI konnte dieses Konzept nicht ohne Weiteres bei uns verankern, und das ist eine entscheidende Lücke, die uns ohne diese Daten entgangen wäre.
Genau solche Erkenntnisse führen zu praktischen Änderungen an den Inhalten: keine oberflächlichen Keyword-Anpassungen, sondern grundlegende Anpassungen daran, wie deine Marke in der Sprache positioniert ist, die KI versteht.
Diesen Arbeitsablauf kann (und sollte) jede Marke in jeder Branche nutzen. Klarheit bekommst du nicht über Nacht, und offen gesagt: Wenn dir ein Tool etwas anderes erzählt, verkauft es dir ein Märchen.
Wenn du aber konsequent Prompts abfragst, Entitäten über die Zeit verfolgst und die Durchschnittswerte auswertest, deckst du auf, wie LLMs das Bild deiner Marke zusammensetzen und wo du eingreifen und es mitgestalten musst.
Um diese Erkenntnisse zu Entitäten in einen einzelnen, vergleichbaren Wert zu überführen, sieh dir an, wie AI Topical Presence Tiefe, Breite und Konzentration zu einer Kennzahl von 0 bis 100 verbindet.
Teil 2: So nutzt du Zitationsdaten aus LLMs
Sprechen wir jetzt über Quellendaten: die Links und Zitationen, auf die LLMs ihre Antworten nach eigener Angabe stützen.
Denk an meinen Vergleich von vorhin, LLMs seien wie Großvater oder Großmutter auf einer Hochzeit. Sie erzählen dir voller Überzeugung, wo sie eine Geschichte gehört haben: „Ach, das war ganz sicher von Jim … oder aus den Nachrichten … oder vielleicht war es dieser seltsame Traum, den ich ’84 hatte.“ So funktionieren Zitationen in Sprachmodellen. Du bekommst eine Quelle, aber ob sie echt oder verlässlich ist oder überhaupt existiert? Das steht auf einem anderen Blatt.
Deshalb ist es genauso wichtig, die Beständigkeit von Quellen zu verfolgen wie die von Entitäten. LLMs nehmen oft Links in ihre Antworten auf, diese folgen aber nicht der klassischen Logik des Zitierens. Manchmal zitieren sie wiederholt glaubwürdige Domains. Manchmal halluzinieren sie ganze URLs. Manchmal mischen sie Bruchstücke zweier verschiedener Websites und nennen dir eine Quelle, die es nicht gibt. Mit der Zeit zeigen sich aber Muster, und diese Muster sind Gold wert.
Die zwei Arten von Prompts und die Zitationen, die sie zutage fördern
Wenn du verstehen willst, wie LLMs deine Marke „sehen“ und woher sie diese Informationen beziehen, musst du genau auf die Quellen achten, die sie zitieren, und vor allem auf die Art von Prompts, die sie auslösen.
Für die KI-Optimierung gibt es zwei Hauptarten von Prompts:
kommerzielle Prompts (z. B. „What are the best brands for holiday booking?“) und
wissensbasierte Prompts (z. B. „What do you know about Brand X?“).
Beide legen unterschiedliche Arten von Erkenntnissen auf Quellenebene offen, und in genau diesem Unterschied liegt der eigentliche Wert.
Kommerzielle Prompts bringen die einflussreichen Domains zum Vorschein
Bei kommerziellen Prompts geht es darum, Marken zu entdecken. Das sind die Fragen, die nachbilden, wie Menschen nach Optionen, Empfehlungen und Ranglisten fragen.
Wenn ein LLM antwortet, liefert es dir nicht nur eine Liste von Marken, es versucht oft, diese Liste mit Zitationen zu begründen. Und diese Zitationen sind eine Karte dessen, was die KI in deinem Bereich für maßgeblich hält. (Zumindest dann, wenn du sie über die Zeit betrachtest!)
Typischerweise siehst du:
-
- Bewertungsaggregatoren
-
- Blogs mit hoher Autorität oder Vergleichsseiten für Tools
-
- Branchenpublikationen
-
- Vertrauenswürdige kommerzielle Inhalte (z. B. Zapier, Backlinko usw.)
So findest du heraus, auf welche Domains sich das LLM stützt, um sich eine Meinung über Marken zu bilden. Wenn du nicht genannt wirst oder deine Wettbewerber zusammen mit bekannten, vertrauenswürdigen Quellen zitiert werden, ist das dein Signal: Hol dir diese Zitation, diese Platzierung oder diesen Beitrag.
Wissens-Prompts zeigen das Gerüst der Markendarstellung
Wissensbasierte Prompts liefern dagegen ausführlichere, beschreibende Informationen über eine einzelne Marke. Und die Quellen zu diesen Antworten unterscheiden sich oft in Art und Ton.
Zu erwarten sind:
-
- Die eigene Website der Marke und ihre Subdomains
-
- Redaktionelle Inhalte, die Hintergrund oder Werte der Marke erklären
-
- Nutzerforen, Interviews, Blogbeiträge: Kontextdaten, die Ton und Persönlichkeit prägen
Diese Quellen haben vielleicht nicht die schiere Domain-Autorität derer aus kommerziellen Prompts. Sie geben dir aber Einblick, wie das LLM das Bild deiner Marke zusammensetzt und welchen umgebenden Kontext es heranzieht, um es zu stützen.
Hier siehst du auch häufiger Halluzinationen: erfundene URLs, halb richtige Zitationen oder Verweise auf veraltete Inhalte. Aber selbst Halluzinationen sind eine Art Erkenntnis: Sie zeigen, wo das LLM Informationen erwartet, auch wenn es sie dort noch nicht gibt.
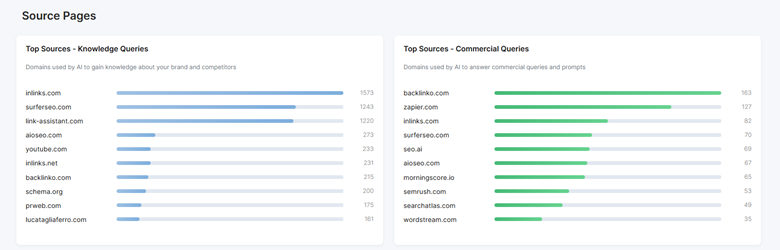
In unseren Daten stach eine Quelle heraus: backlink.io. Sie tauchte immer wieder auf, über mehrere Prompts zu den besten SEO-Tools hinweg. Ob das LLM in jedem Fall richtig lag, ist nicht der Punkt. Der Punkt ist das Muster des Vertrauens.
So machst du aus Quellendaten eine Markenstrategie
Das Diagramm unten entstand nach 30 Tagen Quellenerfassung und zeigt eine wichtige Erkenntnis: Backlink.io wird von LLMs beständig zitiert, sowohl bei kommerziellen Prompts als auch bei wissensbasierten Anfragen. Das ist kein Zufall und auch kein Einzelfall. Es ist ein Signal.
Diese doppelte Präsenz sagt uns zwei entscheidende Dinge:
-
- LLMs behandeln Backlinko als Quelle mit hoher Autorität, sowohl wenn nach Marken-Ranglisten gefragt wird als auch wenn es um Details zu einzelnen Marken geht.
-
- Aufbau, Format und Inhalt der Website funktionieren für die KI-Sichtbarkeit außerordentlich gut.
Backlinko ist aus Sicht des Modells im Grunde eine „bekanntermaßen gute“ Quelle, und das verleiht der Website enormen Einfluss darauf, wer auftaucht und warum. Wenn du in den Nischen SEO und Tools für interne Verlinkung nicht schon auf, neben oder im Vergleich mit Domains wie Backlinko erscheinst, stehst du außerhalb des Vertrauenskreises der KI. Und dieser Kreis bestimmt stark mit, welche Marken in den Ergebnissen erscheinen.
Diese Erkenntnis verändert deine nächsten Schritte:
-
- Lass dich auf Domains erwähnen, denen LLMs bereits vertrauen. Eine Platzierung auf Backlink.io könnte deine LLM-Sichtbarkeit spürbar erhöhen, weil die Website bereits fest in der mentalen Landkarte des Modells verankert ist.
-
- Studiere ihren Aufbau. Websites, die bei LLM-Zitationen gut abschneiden, haben meist stark strukturierte, klar gegliederte und gut crawlbare Inhalte. Es sind nicht nur die Backlinks, es sind Klarheit und Format der Informationen.
-
- Nutze das als Vorlage für deine eigene Präsenz. Wenn du in derselben Zitationsnachbarschaft wie diese Quellen stehst, steigt deine Chance, aufgenommen, erkannt und in Ranglisten geführt zu werden.
Genau diese Art von KI-zentrierter Erkenntnis verschlafen die meisten Marken noch. Wenn du aber bei der LLM-Sichtbarkeit vorne sein willst, musst du wissen, wem das Modell vertraut, und dafür sorgen, dass du direkt daneben stehst..
Fazit
Betrachte zunächst das Gesamtbild deiner Daten. Scheu dich nicht, einen Schritt zurückzutreten und anhand von Trends zu verstehen, was deine Marke ausmacht. Zitationen und Entitätserkennung liefern äußerst nützliche Daten, auch wenn das keine exakte Wissenschaft ist. Sorge also dafür, dass du die Tools hast, um diese Daten über die Zeit zu sammeln.
[Geschrieben von Genie Jones, geprüft und redigiert von Dixon Jones]


