Website-Homonymie in LLMs: eine neue, kritische Herausforderung für die SEO
„Tut mir leid, mein Freund, du verwechselst mich mit jemand anderem …“ So etwas würde deine Website wohl gern jedes Mal sagen, wenn ein LLM sie mit einem mehr oder weniger ähnlichen Homonym verwechselt. Und wie sich zeigt, passiert das viel häufiger, als du vermuten würdest …
Um das zu verstehen, nehmen wir ein Beispiel, das wohl jeder kennt. Wir alle haben diesen besserwisserischen Cousin, dessen nervtötende Gelehrsamkeit die Familienessen würzt. Seine enzyklopädischen Gewissheiten, die er in apodiktischem Ton vorträgt, dulden in der Regel keinen Widerspruch. Es wäre schade, sich das Vergnügen entgehen zu lassen, einen so unausstehlichen Menschen in die Falle zu locken. Frag diesen Narren nach der Bentley-Gruppe und ihrer Website bentley.com, und schon legt er los. Er überschüttet dich mit seinem unerschöpflichen Wissen über die prestigeträchtige britische Automarke, beschreibt mit chirurgischer Präzision die Ausstattung in Vollnarbenleder, die Leistung des W12-Motors und sogar die persönliche Geschichte von Walter Owen Bentley, ohne auch nur eine Sekunde in Betracht zu ziehen, dass etwas anderes gemeint sein könnte. Dabei gehört der Domainname bentley.com Bentley Systems, einem Software-Engineering-Unternehmen, das mit Luxusautos rein gar nichts zu tun hat. Nimm das, Cousin!
Ob du es glaubst oder nicht: LLMs machen genau denselben Fehler wie dieser unerträgliche Cousin und verbinden den Domainnamen bentley.com mit der Automarke. Willkommen in der faszinierenden Welt der Website-Homonymie im Zeitalter der LLMs, in der die Frage „Was weiß ein LLM wirklich über mysite.com?“ existenziell wird. In einer Welt, in der diese Modelle, gefüttert mit Milliarden von Texten, aber ohne strukturierten Knowledge Graph, ihre Nachlässigkeit zeigen, sobald man von ihnen auch nur ein wenig Faktentreue verlangt.
Während klassische Suchmaschinen zwei Jahrzehnte damit verbracht haben, ihre Knowledge Graphs zu verfeinern, um Homonyme auseinanderzuhalten, werfen LLMs Websites weiterhin munter durcheinander.
Und so wird uns SEO-Profis schlagartig klar, dass all die Jahre, in denen wir Title-Tags und Meta Descriptions optimiert haben, womöglich nutzlos sind gegen ein System, das die hochseriöse Buchhaltungskanzlei „Martin & Associates“ mit einer gleichnamigen Zoohandlung am anderen Ende des Landes verwechselt. Was für eine Enttäuschung!
In diesem Artikel erkunden wir dieses Neuland der Suchmaschinenoptimierung, das noch wenig bekannt, aber inzwischen unumgänglich ist. Wir zeigen, warum diese Identitätsverwechslung keine bloß amüsante Anekdote ist, sondern ein bedeutendes Problem für deine Sichtbarkeit, deine Autorität und letztlich für deine Fähigkeit, digital zu existieren, in einer Welt, in der LLMs nach und nach zu den Torwächtern des Zugangs zu Informationen werden.
Schnall dich an: Das Abenteuer verspricht ebenso lehrreich wie beunruhigend zu werden.
I. Wie LLMs Websites identifizieren
Wie URLs und Domains verarbeitet werden
Große Sprachmodelle verarbeiten Informationen grundlegend anders als Suchmaschinen. Wo Google über einen geordneten Index von Webseiten mit präzisen Metadaten verfügt, erkennen LLMs Textmuster in ihrem Trainingskorpus. Konkret heißt das: Ein LLM hat keine Datenbank von Websites, sondern lediglich statistische Verknüpfungen zwischen Token-Folgen.
Ein Domainname wie „mysite.com“ ist deshalb kein eigener Eintrag in einem Index, sondern eine Reihe von Tokens, denen das Modell in seinen Trainingsdaten begegnet ist, verbunden mit bestimmten Kontexten oder Informationen.
Der grundlegende Unterschied: Erkennen und Verstehen
Es ist ein entscheidender Unterschied, ob ein Modell die Existenz eines Domainnamens erkennt (also weiß, dass „mysite.com“ eine Website ist) oder die Identität dieser Website versteht (also weiß, was „mysite.com“ ist, in welcher Branche die Website tätig ist, welche Inhalte sie hat usw.)
LLMs erkennen leicht, dass eine Zeichenfolge ein Domainname ist. Ihr „Verständnis“ dessen, wofür diese Website steht, hängt aber vollständig von den Textverknüpfungen in ihrem Trainingskorpus ab.
Die Grenzen der Tokenisierung bei Domainnamen
Die Tokenisierung der LLMs bringt eine weitere Schwierigkeit mit sich: Je nach Modell kann ein Domainname in mehrere Tokens zerlegt werden, was seine genaue Identifizierung erschwert. So könnte „expert-accountant-london.com“ in mehrere Fragmente zerlegt werden. Dadurch fällt es dem Modell schwerer, diese Website durchgängig als eine einzige Entität abzubilden.
Diese technische Fragmentierung und das Fehlen eines formalen Systems zur Identifizierung von Websites erklären, warum LLMs Websites mit ähnlichen Namen oder verwandten Themen leicht verwechseln können.
Wer sich für eine vertiefte Analyse der Homonymie im weiteren Sinn bei LLMs interessiert, findet hier einen wissenschaftlichen Artikel, der das Thema ernsthaft untersucht.
Diese unterschiedlichen Ansätze zeigen sich ganz konkret darin, wie jedes System mit zwei Entitäten umgeht, die doch klar voneinander verschieden sind.
II. Suchmaschinen und LLMs: zwei Modelle, Websites zu identifizieren
Wie Suchmaschinen eine Website identifizieren
Suchmaschinen wie Google haben ausgefeilte Systeme entwickelt, um Websites eindeutig zu identifizieren:
- Knowledge Graphs: Sie ordnen eine Domain einer bestimmten Entität zu, mit klar definierten Attributen und Beziehungen.
- Strukturierte Daten: Mit Schema.org und anderem Markup können Websites ihre Identität ausdrücklich angeben.
- Backlink-Analyse: Das Profil der eingehenden Links hilft, die Identität der Website einzuordnen und näher zu bestimmen.
- Nutzersignale: Die Interaktionen der Nutzer mit der Website helfen, ihr Bild zu verfeinern.
Mit diesem mehrdimensionalen Ansatz können Suchmaschinen gleichnamige oder ähnliche Websites wirksam auseinanderhalten und Verwechslungen vermeiden.
Wie LLMs eine Website „verstehen“
Aktuelle LLMs haben dagegen keinen Knowledge Graph für Websites. Sie stützen sich ganz auf die Texterwähnungen in ihrem Trainingskorpus, und ihnen fehlen eigene Mechanismen, um Domainnamen eindeutig zuzuordnen. Deshalb verwechseln sie leicht Websites, die ähnlich heißen oder ähnliche Themen anklingen lassen.
Anscheinend stützen sie sich auch stark auf Backlinks, die auf deine Website zeigen. Daraus könnten sie also einige Informationen gewinnen, vorausgesetzt, die Links sind nicht knapp formuliert, sondern erlauben im Gegenteil eine Einordnung in den Kontext. Wir arbeiten aktiv daran, diesen Punkt zu klären.
Dieser grundlegende Unterschied in der Architektur erklärt, warum ein LLM deiner Website Eigenschaften zuschreiben kann, die in Wahrheit zu einer gleichnamigen Website gehören, oder umgekehrt.
Fallbeispiele im Vergleich
Nehmen wir zwei fiktive Websites: „centrale-assurance.com“ (Versicherungsmakler) und „centrale-assurances.net“ (Blog über Versicherungen).
Eine Suchmaschine wie Google unterscheidet diese beiden Websites korrekt, dank ihrer unterschiedlichen Backlink-Profile, ihrer strukturierten Daten und der Analyse ihrer Inhalte. Die Suchmaschine versteht, dass es sich um zwei verschiedene Entitäten handelt.
In einem LLM dagegen besteht die Gefahr, dass die beiden Websites verwechselt werden. Fragt ein Nutzer „Welche Leistungen bietet centrale-assurance an?“, könnte das Modell in seiner Antwort Informationen beider Websites vermengen und so ein hybrides, unzutreffendes Bild erzeugen.
Neue Herausforderungen bringen neue Probleme …
III. Die konkreten Risiken für die digitale Identität deiner Website
Identitätsfehler
Das erste und schwerwiegendste Risiko ist die vollständige Verwechslung deiner Website mit einem Homonym. In diesem Fall schreibt das LLM deiner Website Eigenschaften, Inhalte oder Leistungen zu, die in Wahrheit zu einer anderen Website mit ähnlichem Namen gehören. Das öffnet allen möglichen Katastrophen die Tür: Inhalte oder Leistungen werden falsch zugeordnet, die Identitäten mehrerer Websites verschmelzen zu einer einzigen unscharfen Entität, oder deine Marke wird mit Informationen oder Eigenschaften verbunden, die nicht zu dir passen.
So könnte die Website einer Buchhaltungskanzlei namens „Dupont Conseil“ mit der eines gleichnamigen Strategieberaters verwechselt werden, was ihre Leistungen völlig falsch darstellen würde.
Verwässerung der Branchenexpertise
Verwechselt das LLM deine Website mit anderen aus derselben Branche, kann es deine besondere Expertise Wettbewerbern zuschreiben, deine eigenständige Positionierung bei Themen schwächen, in denen du führend bist, und deine Autorität verwässern, indem es sie auf mehrere ähnliche Entitäten verteilt.
Diese thematische Verwechslung schadet besonders Websites, deren Wert auf spezialisierter Expertise oder einer unterscheidenden Positionierung beruht.
Folgen für Empfehlungen und Traffic
Die Identitätsverwechslung wirkt sich direkt auf Traffic und Conversions aus: LLMs können ausdrücklich Websites von Wettbewerbern empfehlen, in der Annahme, es gehe um deine, Nutzer können auf gleichnamige Websites umgeleitet werden, und die Zuordnung von Inhalten kann deinen Wettbewerbern statt dir zugutekommen.
Da LLMs zu unumgänglichen Vermittlern beim Zugang zu Informationen werden, kann diese Verwechslung also erhebliche Folgen für deine Traffic-Gewinnung haben.
IV. Verschärfende technische Faktoren, die du im Blick behalten solltest
Generische oder beschreibende Domainnamen: Ein früherer SEO-Vorteil kehrt sich um
Websites mit generischen oder beschreibenden Domainnamen sind für Identitätsverwechslungen in LLMs besonders anfällig. Zum Beispiel:
- „cheap-car-insurance.com“
- „best-plumber-new-york.com“
- „mortgage-loan-comparator.com“
Von klassischer SEO zu LLMs: Das Blatt wendet sich
Fast zwei Jahrzehnte lang war es eine empfohlene und wirksame SEO-Praxis, beschreibende Domainnamen mit strategischen Keywords zu verwenden. In der Welt der klassischen Suchmaschinen hatte dieser Ansatz mehrere Vorteile:
- Direkter Vorteil in den Algorithmen: Früher gaben Suchmaschinen Keywords im Domainnamen erhebliches Gewicht
- Optimierte natürliche Linktexte: Links auf diese Websites enthielten ganz von selbst die Ziel-Keywords
- Leichter zu merken: Nutzer verbanden den Namen der Website leichter mit ihrer Funktion
Diese Strategie blieb trotz der Weiterentwicklung der Algorithmen insgesamt vorteilhaft. Zumindest bis die LLMs aufkamen …
Ein großes Handicap im KI-Zeitalter
Was einst ein Vorteil war, wird jetzt zur Schwachstelle:
- Verwässerung in generischen Begriffen: Beschreibende Namen werden in Trainingskorpora häufig generisch erwähnt. Dadurch geht die eigene Identität der Website in einem breiteren Begriff auf.
- Viele ähnliche Wettbewerber: Zahlreiche Websites haben ähnliche Namen gewählt. So entstehen Gruppen fast identischer Domains, die LLMs nur schwer auseinanderhalten.
- Verwechslung mit Suchanfragen: Ein LLM kann den Domainnamen mit einer beschreibenden Anfrage verwechseln, wodurch die Identität der Website noch weiter untergeht
Fragt ein Nutzer zum Beispiel nach Informationen zu „mortgage-loan-comparator.com“, kann das LLM dies als allgemeine Anfrage zu Vergleichsportalen für Hypothekendarlehen deuten statt als Frage zu dieser bestimmten Website. Das Modell liefert dann möglicherweise allgemeine Informationen oder nennt mehrere konkurrierende Websites, und die eigene Identität der Domain löst sich vollständig auf. Wahrscheinlich haben Websites mit beschreibenden Domainnamen in LLM-Antworten häufiger Identitätsprobleme als Websites mit unverwechselbaren Markennamen.
Websites mit geringer Präsenz im Trainingskorpus
Neue Websites oder solche, die in den Trainingskorpora der LLMs nur schwach vertreten sind, sind dem Verwechslungsrisiko besonders ausgesetzt. Den LLMs stehen nämlich weniger Beispiele zur Verfügung, um die eigene Identität dieser Websites zu verstehen. Zudem begünstigt der fehlende Kontext die Verwechslung mit etablierteren Websites. Und schließlich erschwert das Fehlen qualifizierter Erwähnungen ein zutreffendes Bild.
Dieser Mangel an „Kontextualisierung“ trifft vor allem neue Anbieter und KMU, deren Online-Präsenz begrenzter ist.
Namensänderungen oder Migrationen
Websites, die ihren Namen geändert haben oder auf eine neue Domain umgezogen sind, stehen vor einer besonderen Herausforderung: LLMs behalten die alte Verknüpfung von Domain und Identität oft lange bei, weil zwischen den Aktualisierungen ihrer Trainingsdaten zeitliche Abstände liegen. Gleichzeitig sorgt das vorübergehende Nebeneinander beider Namen für anhaltende Verwirrung. Hinzu kommt: Ob das Modell sein Wissen aktualisiert, hängt davon ab, dass neue Informationen in künftige Trainingsdaten einfließen.
Diese für LLMs typische Trägheit kann die Identitätsverwechslung weit über die Phase der technischen Umstellung hinaus verlängern. Du hast es also nicht nur mit einem neuen Problem zu tun, es könnte sich auch als hartnäckig erweisen …
V. Gekaperte Identität: die böswillige Ausnutzung der Website-Homonymie
Parasitäre Strategien rund um digitale Identitäten
Neben der natürlichen Verwechslung könnten manche Akteure die Schwächen der LLMs gezielt ausnutzen, um sich an die Identität etablierter Websites zu hängen, und damit Praktiken fortführen, die aus der Welt der Suchmaschinen längst bekannt sind. Tatsächlich werden Homonymie und Namensähnlichkeiten seit den Anfängen des Webs ausgenutzt. Mit LLMs bekäme das aber eine neue Dimension: durch den Erwerb ähnlicher Namen (absichtliche Schreibfehler, TLD-Varianten), um von der Verwechslung zu profitieren, durch die Weiterentwicklung alter Cybersquatting-Praktiken, die gezielt die Verwechslung in LLMs ausnutzen, oder durch die strategische Nachbildung bestimmter Originalinhalte oder Elemente.
Diese Techniken erinnern zwar an jene, mit denen schon klassische Suchmaschinen getäuscht wurden. Bei LLMs wären sie aber möglicherweise wirksamer, weil ihre Mechanismen des Verstehens andere sind und strukturierte Knowledge Graphs fehlen.
Solche böswilligen Praktiken würden darauf abzielen, Traffic abzufangen oder vom Ruf einer etablierten Marke zu profitieren, ohne in deren Aufbau zu investieren. Sei also wachsam und halte die Augen offen!
Konkrete Beispiele für digitalen Identitätsmissbrauch:
- Der Fall LinkedIn und LinkedUp: 2014 verklagte Microsoft das berufliche soziale Netzwerk „LinkedUp“ wegen Markenverletzung, mit dem Argument, der Name sei bewusst gewählt worden, um Verwechslungen mit LinkedIn hervorzurufen. Der Fall veranschaulicht perfekt, wie sich Namensähnlichkeit ausnutzen lässt, um von der Bekanntheit einer etablierten Marke zu profitieren.
- Amazon und Shops wie „amazan“, „amaazon“ usw.: Viele Onlineshops haben versucht, Schreibvarianten auszunutzen, die Amazon ähneln, etwa amazan.com, amaazon.com oder amazonn.net. Amazon musste gegen mehrere dieser Websites rechtlich vorgehen, die nicht nur ähnliche Namen verwendeten, sondern auch visuelle Elemente und Seitenstrukturen, die an die Originalplattform erinnerten.
- Google und Googel: Die Website googel.com hat lange Traffic abgefangen, der für Google bestimmt war, indem sie einen häufigen Tippfehler ausnutzte. Dieses „Typosquatting“ ist bis heute eine der am weitesten verbreiteten Formen des digitalen Identitätsmissbrauchs.
Diese Beispiele stammen zwar aus der Zeit vor den LLMs, zeigen aber, dass das Ausnutzen von Homonymie eine etablierte Praxis ist. Mit LLMs könnte sich diese Strategie als noch wirksamer erweisen, weil es diesen Modellen möglicherweise schwerer fällt als klassischen Suchmaschinen, solche ähnlichen Entitäten zu unterscheiden.
Folgen für das Vertrauen der Nutzer
Die Folgen dieser böswilligen Praktiken würden über die unmittelbar Betroffenen hinausgehen: Sie würden das Vertrauen in die Informationen der LLMs nach und nach untergraben, und Nutzer würden den Website-Empfehlungen zunehmend misstrauen. Wenn echte Expertise angesichts immer zahlreicherer Fälle von Identitätsmissbrauch an Wert verliert, könnte das Akteure im Web, die bisher als Experten anerkannt waren, vor ernste Probleme stellen.
VI. Einige Beispiele für bemerkenswerte Verwechslungen
Das Paradebeispiel Bentley: Legitime Homonymie, die für Verwirrung sorgt
Wie in der Einleitung erwähnt, betrifft ein besonders aufschlussreiches Beispiel für die Herausforderungen der Homonymie die Marke Bentley. Anders als viele von euch vielleicht denken, gehört die Domain bentley.com nicht dem berühmten britischen Luxusautohersteller (Bentley Motors), sondern Bentley Systems, einem Unternehmen für Engineering-Software, das auf Infrastrukturlösungen spezialisiert ist. Der Autohersteller musste sich mit bentleymotors.com als Hauptdomain begnügen. Was für eine Panne!
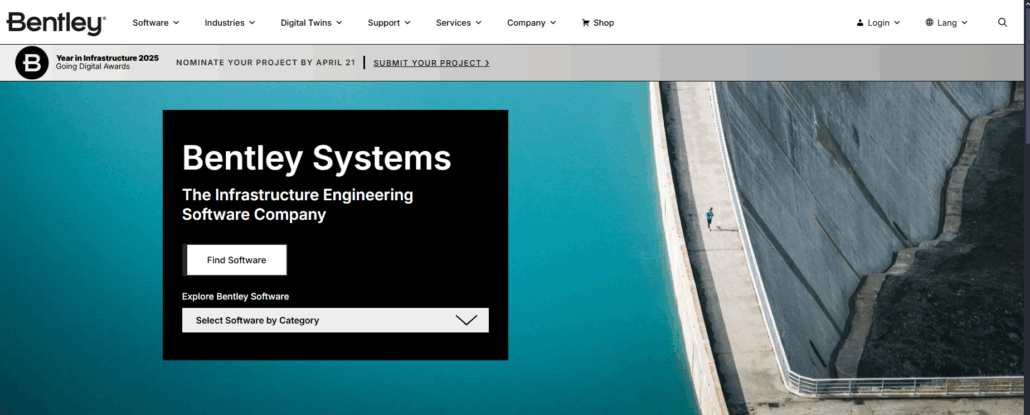
Screenshot der Startseite von bentley.com
Diese Situation ist ein Lehrbuchbeispiel dafür, was LLMs für das Management digitaler Identitäten bedeuten:
- Verwirrung bei Nutzern: Die Mehrheit der Nutzer verbindet „Bentley“ intuitiv mit Luxusautos. Fragt ein Nutzer ein LLM nach Informationen zu „bentley.com“, könnte das Modell ohne Prüfung Informationen über Bentley Systems (den rechtmäßigen Inhaber der Domain) liefern, während der Nutzer Informationen über den Autohersteller erwartet.
- Legitime Mehrdeutigkeit vs. Missbrauch: Anders als bei bewusstem Identitätsmissbrauch handelt es sich hier um eine legitime Homonymie zwischen zwei etablierten Unternehmen aus unterschiedlichen Branchen. Der herkömmliche Rechtsrahmen bietet keine naheliegende Lösung, da beide Unternehmen legitime Rechte am Namen „Bentley“ haben.
- Verantwortung der LLMs: Der Fall wirft die Frage auf, welche Verantwortung LLMs bei der eindeutigen Zuordnung tragen. Sollten sie versuchen zu klären, wonach der Nutzer wirklich sucht, bevor sie antworten? Wie sollten sie mit dieser Mehrdeutigkeit umgehen?
Weitere Paradebeispiele: Tesla und Nissan
Weitere bemerkenswerte Beispiele veranschaulichen diese Herausforderungen rund um die digitale Identität:
Tesla und der späte Erwerb der eigenen Domain: Viele Jahre lang gehörte tesla.com nicht Tesla Motors. Das berühmte Unternehmen von Elon Musk musste sich bis 2016 mit teslamotors.com begnügen, bis es ihm schließlich gelang, die Domain zu erwerben, die genau seinem Namen entspricht. Dieser vorübergehende Zustand sorgte fast ein Jahrzehnt lang für mögliche Verwirrung: Nutzer, die im Web nach Tesla suchten, landeten unter Umständen nicht auf der offiziellen Website des Autoherstellers.
Nissan.com und der Rechtsstreit: Ein noch eindrücklicherer Fall ist nissan.com. Die Domain gehört nicht dem japanischen Autohersteller, sondern Uzi Nissan, einem amerikanischen Unternehmer, der sie 1994 für seine Computerfirma Nissan Computer registriert hat. Trotz jahrelanger Rechtsstreitigkeiten ist es Nissan Motors nicht gelungen, die Kontrolle über die Domain zu erlangen, und das Unternehmen muss sich für den amerikanischen Markt mit nissanusa.com begnügen. Dieser Zustand dauert seit mehr als 25 Jahren an und ist ein Musterbeispiel für die Verwechslung digitaler Identitäten: Der durchschnittliche Nutzer verbindet „Nissan“ ganz selbstverständlich mit Autos, die Domain nissan.com führt aber zu einer völlig anderen Entität. Unglaublich!
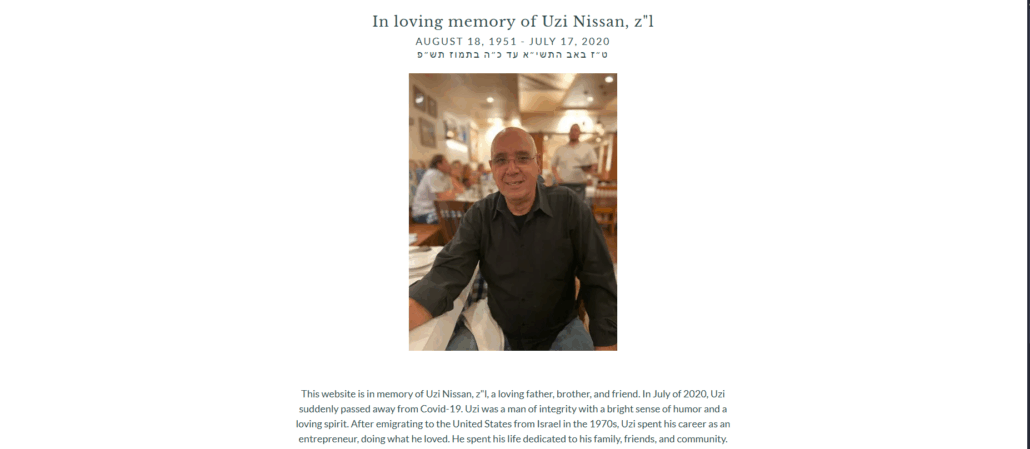
Screenshot der Startseite von nissan.com
Diese Fälle veranschaulichen perfekt, vor welchen Herausforderungen LLMs stehen: Wie beantwortet man eine Anfrage zu „nissan.com“ korrekt, ohne den Nutzer in die Irre zu führen, und respektiert dabei, wem die Domain tatsächlich gehört?
Diese Verwechslung digitaler Identitäten schafft auch ohne böse Absicht einen Nährboden für Missverständnisse und problematische Nutzererlebnisse im Umgang mit LLMs.
Siehst du, wie deine Online-Existenz auf dem Spiel stehen könnte?
VII. Survival-Kit: So stärkst du die unverwechselbare Identität deiner Website
Erweiterte strukturierte Daten einsetzen
Strukturierte Daten spielen eine entscheidende Rolle, wenn es darum geht, die Einzigartigkeit deiner Website gegenüber LLMs zu stärken:
- Schema.org vollständig umsetzen: Nutze die Typen organization, website und brand, um deine Identität ausdrücklich anzugeben
- Einheitliches Markup auf der gesamten Website: Sorge dafür, dass es auf allen Seiten systematisch umgesetzt ist
- Verbindungen zwischen Entitäten schaffen: Stelle klare Bezüge zwischen deiner Website, deiner Organisation und deinen Inhalten her
- Eigenschaften zur Unterscheidung nutzen: Verknüpfe deine Website über Attribute wie „sameAs“ mit deinen offiziellen Auftritten auf anderen Plattformen
Dieser Ansatz trägt dazu bei, einen internen Knowledge Graph aufzubauen, der die eindeutige Identifizierung deiner Website erleichtert.
Einen unverwechselbaren sprachlichen Fußabdruck entwickeln
Eine wiedererkennbare sprachliche Handschrift stärkt die unverwechselbare Identität deiner Website. Verwende ein Vokabular, das zu deiner Marke gehört, setze in deinen Inhalten auf wiedererkennbare Wendungen und pflege eine eigene redaktionelle Stimme, insbesondere mit wiederkehrenden Formulierungen, damit sie zu deinem Markenzeichen werden.
Dieser unverwechselbare sprachliche Fußabdruck erleichtert es, deine Website in den Vektorrepräsentationen der LLMs zu unterscheiden.
Eigene Inhalte zur Selbstidentifikation erstellen
Erstelle Inhalte, die ausdrücklich dazu dienen, die unverwechselbare Identität deiner Website zu klären. Achte dabei besonders auf deine „Über uns“-Seite, die in diesem Zusammenhang eine entscheidende Rolle spielt.
Die „Über uns“-Seite: Grundpfeiler deiner digitalen Identität
Die lange verschmähte „Über uns“-Seite (oder „Wer wir sind“) ist gegenüber LLMs ein Faktor, mit dem sich deine Identität abgrenzen lässt, weit über ihre traditionelle Rolle als selbstbezogenes Schaufenster hinaus. Dabei messen LLMs dieser Seite oft erhebliches Gewicht bei, wenn sie sich ein Bild von einer Website machen. Sie gilt in der Regel als maßgebliche und vertrauenswürdige Aussage zur eigenen Identität, vor allem weil sie die zentralen Elemente bündelt, mit denen LLMs eine Website einordnen: Geschichte, Mission, Team, Positionierung, Unterscheidungsmerkmale. Außerdem ist sie der ideale Ort, um mögliche Unklarheiten über deine Identität auszuräumen, besonders bei bekannter Homonymie. Mehr dazu: unsere ausführliche Methode zur Optimierung der „Über uns“-Seite
VIII. Deine Abgrenzungsstrategie messen und optimieren
Waikay, ein Tool, das der Herausforderung gewachsen ist
Zum Glück ist der Himmel auf deiner Seite. Mit unserem Tool Waikay prüfst du genau, was LLMs über deine Website wissen, und bekommst Ansatzpunkte, um Probleme zu lösen. Falls es unglücklicherweise welche geben sollte … woran wir nicht zweifeln.
Mit Waikay erstellst du einen Report zu deiner Marke: Du gibst deinen vollständigen Domainnamen ein und filterst die Aussagen, die Waikay über dich meldet, nach den verschiedenen LLMs. Sehen wir uns nissan.com an, die bereits erwähnte Gedenkseite.
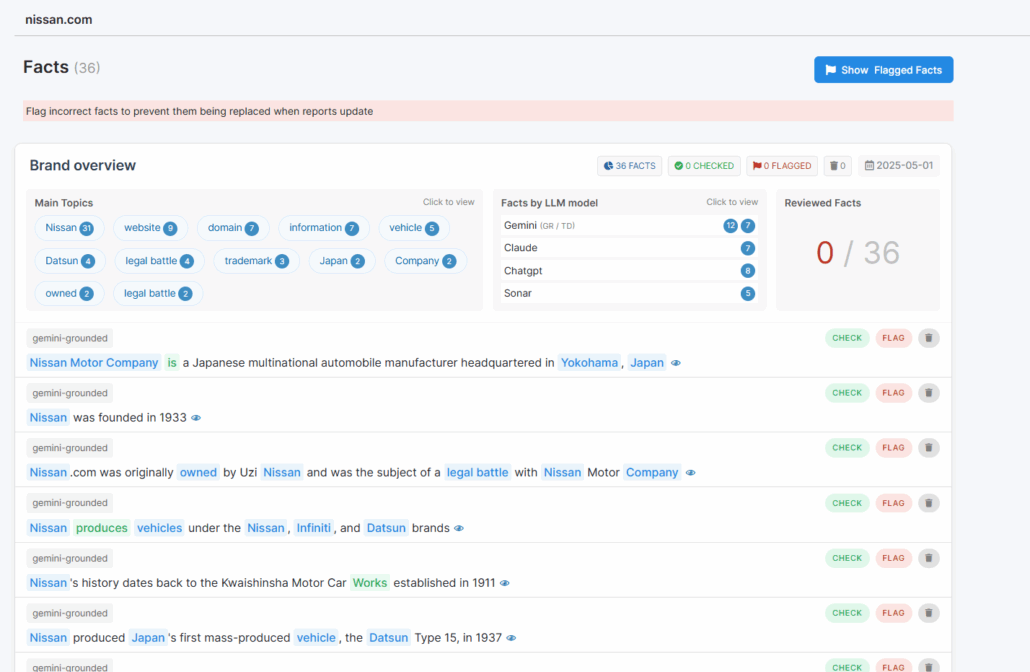
Waikay fordert ChatGPT, Gemini, Sonar und Claude auf, einen KI-Überblick über diese Website zu geben. Daraus entsteht eine Liste der gemeldeten Aussagen, die du markieren und über die Zeit beobachten kannst. In diesem besonderen Fall haben alle LLMs falsche Fakten gemeldet, obwohl wir ihnen direkten Zugriff auf die Website gegeben haben. Das zeigt, wie durchwachsen das Verständnis der KI von Websites ist, und du kannst alles genau unter die Lupe nehmen, was deine Darstellung im Netz betrifft.
Außerdem kannst du diese Aussagen mit Kontext versehen. Für Entitäten, die mit deiner Website verbunden sind, kannst du eigene Projekte anlegen. Betrachten wir nissan.com zum Beispiel im Kontext von ‚memorial‘, werden die Aussagen plötzlich etwas relevanter.
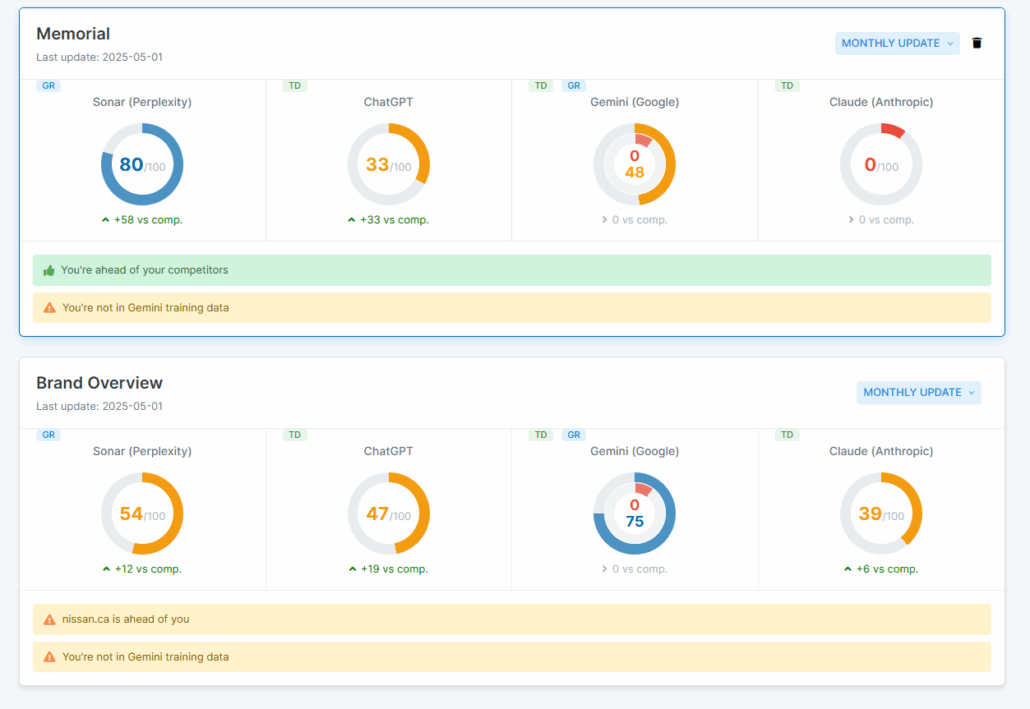
So lässt sich nicht nur beobachten, wie unglaublich fest die Markenpräsenz des Autoherstellers Nissan die KI im Griff hat, sondern auch, welche LLMs sich leichter auf neue Informationen einstellen. Sonar und Gemini scheinen in diesem Wissensrennen vorn zu liegen. Damit kann Nissan (der Autohersteller) oder Nissan (die Gedenkseite) messen, wie die KI den Streit versteht.
Ein interessanter Fall mit etwas mehr SEO-Bezug könnte Majestic.com sein. Eine Marke mit enormer Autorität und klar umrissener Online-Präsenz sollte eigentlich nicht verwechselt werden. Trotzdem lohnt es sich, mit Waikay zu prüfen, ob sich gleichnamige Marken in dieses Feld drängen. Majestic.com steht für die SEO-Marke, majestic.co.uk für das Weinunternehmen. Interessanterweise tauchte keine von beiden im KI-Überblick auf, dafür aber die kanadische Agentur Majestic (Grüße an canadianmajestic!).
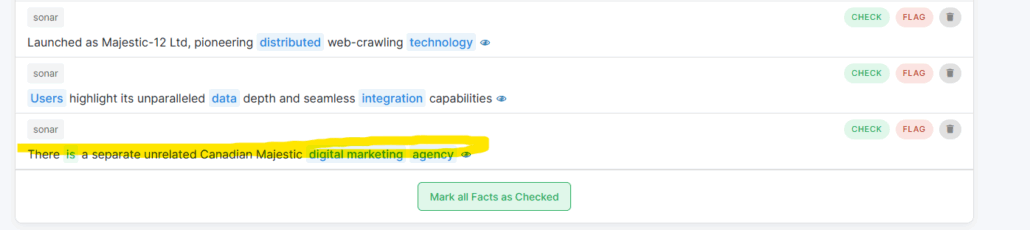
Und so einfach findest du mit Waikay heraus, wo du womöglich Opfer von Marken-Homonymie wirst! Es lohnt sich, das im Blick zu behalten, damit andere Marken deine Darstellung im Netz nicht verzerren, und Waikay ist ein hervorragender und gründlicher Weg, das zu verfolgen.
Stellt sich heraus, dass das Bild tatsächlich verzerrt ist, empfehle ich dir einen Blick auf die Quellen, die Waikay liefert. Eine verzerrte Darstellung stammt oft von Bewertungsportalen Dritter. Geh also zum Tab „Mentions“ und sieh dir die „Unique Domains“ an: Dort findest du einige der eher … speziellen … Websites, aus denen die KI deine Daten zieht.
Manuelle Testmethoden mit LLMs
Neben spezialisierten Tools gibt es mehrere Ansätze, mit denen du prüfen kannst, wie gut LLMs deine Website erkennen:
- Tests mit Prompt Engineering: Entwickle Reihen gezielter Fragen, um zu prüfen, wie genau das Wissen der LLMs über deine Website ist:
- Direktes Erkennen:
- „What is [yoursite.com]?“
- „What is the business sector of [yoursite.com]?“
- Einfache Verwechslung:
- „What is the difference between [yoursite.com] and [homonymous-competitor.com]?“
- Zuordnung:
- „Who developed/created [product or service specific to your company]?“
- Kontext:
- „I’m looking for [service you offer] in [your location]. Which sites do you recommend?“
- Unterscheidung:
- „I’m confused between several companies named [your name]. Can you help me distinguish them?“
- Gesprächsgedächtnis:
- Erwähne zuerst einen gleichnamigen Wettbewerber und frag dann nach Informationen über „this company“, ohne es erneut beim Namen zu nennen
- Direktes Erkennen:
- Vergleichstests: Analysiere, wie LLMs deine Website von ähnlichen Domains unterscheiden (oder mit ihnen verwechseln)
- Analyse generierter Inhalte: Prüfe, wie deine Website in Branchenübersichten oder thematischen Empfehlungen dargestellt wird
Natürlich brauchen diese Tests eine strenge Bewertungsmethode (Skala von 1 bis 10), um den Grad der Verwechslung objektiv zu messen. Sind wir Profis oder nicht?
Diese ergänzenden Methoden sind zwar zeitaufwendig, erlauben aber eine qualitative Bewertung, wie deine Website in LLMs dargestellt wird. Allerdings geht nichts über das Tempo und die fast sofortige Vollständigkeit unseres Tools …
Fazit
Wir stehen am Beginn einer neuen SEO-Ära: Nachdem wir uns jahrelang darum gesorgt haben, was Google von uns hält, müssen wir uns jetzt darum sorgen, was Sprachmodelle über uns wissen.
Das Problem der Website-Homonymie in LLMs ist keine bloße technische Kuriosität für Geeks. Es ist ein bedeutendes Problem, das deine mühsame SEO-Arbeit durchaus in eine Sandburg bei Flut verwandeln könnte. Was nützt schließlich Platz eins bei Google, wenn Claude oder ChatGPT dich systematisch mit einer Kochseite verwechselt oder, schlimmer noch, mit einer Pornoseite?
SEO-Profis stehen damit vor einer neuen Herausforderung: Sie müssen nicht mehr nur dem Google-Algorithmus gefallen, sondern jetzt auch dafür sorgen, dass LLMs nicht an einer fortgeschrittenen Form digitaler Prosopagnosie leiden (ein Wort, das sich immer gut macht), wenn es um deine Website geht. Die Aufgabe ist umso komplexer, als diese Modelle wie undurchdringliche Blackboxes funktionieren: Ihre Verwechslungen lassen sich nur indirekt korrigieren, und die Verzögerung bemisst sich in Modellversionen statt in Tagen.
Was also tun? Wahrscheinlich fängst du am besten damit an, das Thema ernst zu nehmen, bevor dein CEO entdeckt, dass dein Cybersecurity-Unternehmen laut ChatGPT in Wahrheit „hervorragende vergünstigte Nilkreuzfahrten“ anbietet. Damit stehst du besser da als deine Wettbewerber, die dieses neue SEO-Terrain weiter ignorieren.
Und wer weiß? Vielleicht entwickeln LLMs eines Tages („I had a dream“) genug Urteilsvermögen, um dein Architekturbüro „Perspective Design“ von einem Blog über optische Täuschungen zu unterscheiden, der sich auf perspective-design.net breitgemacht hat. Bis dahin betrachte Homonymie als den neuen Spielplatz (oder eher das Schlachtfeld) der modernen Suchmaschinenoptimierung.
Wie ein griechischer Philosoph sagte, dessen Name mir entfallen ist: „Verwechselt zu werden oder nicht gelistet zu sein, ist haargenau dasselbe.“ Oder so ähnlich.


