Was sind die besten Entity-SEO-Tools? Wenn ChatGPT Verwirrung stiftet
Die detaillierte technische Analyse einer KI-Antwort zeigt, wie Desinformation aktiv erzeugt wird: 70 % ungeeignete Antworten, empfohlen mit befremdlicher Autorität. Ein erschreckender Befund!
Die Arbeit an der Verfeinerung von Waikay, unserem Tool zur Markenanalyse in LLMs, bringt unerwartete Ergebnisse hervor. Sie zeigen sehr anschaulich, welche ernsten Probleme entstehen, wenn man LLMs anstelle von Suchmaschinen nutzt.
Suchmaschinen und LLMs funktionieren nämlich nicht auf dieselbe Weise. Die einen liefern uns eine Liste von Quellen in Form von URLs, die wir aufrufen sollten, um uns eine eigene Meinung zu bilden. LLMs dagegen liefern analytische Zusammenfassungen ebendieser Quellen. Der Unterschied ist enorm: Das eine bietet Informationen, die man zerlegen und bewerten kann, das andere „fertig vorgedachte“ Antworten.
Unsere Untersuchung zeigt an einem konkreten Beispiel die Grenzen, Verzerrungen und Probleme, die mit der Nutzung von LLMs als Suchmaschinen einhergehen. Dieser Trend verstärkt sich und dürfte schnell zur Norm werden. Das zwingt uns, wachsam zu bleiben.
Zu wissen, was LLMs über unsere Marken und Unternehmen wissen, ist einer der Gründe, die uns dazu gebracht haben, Waikay zu entwickeln. Wir müssen feststellen: Dieses Tool hat gute Zeiten vor sich.
Das ist passiert …
Das aufschlussreiche Experiment zu Entity-SEO-Tools
Wir haben ChatGPT folgende Frage gestellt: „What are the best SEO entity tools on the market?“, in der festen Überzeugung, dass wir eines der besten, wenn nicht DAS beste Tool sind, das es heute gibt.
Das war die Antwort: eine Liste mit 10 Tools, vorgetragen mit der Selbstsicherheit und der algorithmischen Autorität, die für ein LLM typisch sind: Ahrefs, Semrush, seoClarity, Yext, InLinks, Conductor, BrightEdge, SE Ranking, Semrush Company, WordLift.
Das Problem: Unsere Erfahrung in der SEO und besonders beim komplexen Thema der benannten Entitäten hat uns stutzig gemacht. Wir kennen den Wettbewerb, und wir wissen, dass einige der aufgeführten Websites keine Analyse benannter Entitäten anbieten.
Schlimmer noch: Die Liste enthält ein und dasselbe Unternehmen unter zwei verschiedenen Namen. Zwei der vorgeschlagenen Websites sind in Wahrheit eine!
Aber warum hat sich ChatGPT in eine so unpassende Antwort verrannt?
Erste Beobachtung, die natürlich im Mittelpunkt unserer Überlegungen stehen wird: Diese Liste gibt es nirgendwo im Web. Aus gutem Grund, denn ChatGPT hat sie vollständig selbst fabriziert und dabei seine Trainingsdaten und Online-Suchen ohne Maß zusammengefasst, die leider beide verzerrt sind. Dazu kommt ein Anteil Halluzinationen.
Dieser Fall zeigt ein wiederkehrendes Phänomen: Jede Frage, ob technisch oder nicht, kann falsche Empfehlungen hervorbringen, die mit Autorität vorgetragen werden, und Nutzer bei Fachthemen aller Art in die Irre führen.
Technische Analyse: echte und falsche Entity-SEO-Tools
Um sicherzugehen, dass das Problem real ist, haben wir jede Website auf dieser von ChatGPT zusammengestellten Liste einzeln daraufhin geprüft, ob sie tatsächlich eine Erkennung benannter Entitäten anbietet oder nicht.
Die Ergebnisse waren zwar zu erwarten, sind aber dennoch beunruhigend. Nur ein Drittel der Antworten ist richtig. Sehen wir uns zuerst die drei richtigen Ergebnisse an, unter denen auch wir sind, allerdings nicht auf einem besonders guten Platz:
✅ Die 3 Tools (30 %), die wirklich auf die Extraktion benannter Entitäten ausgelegt sind
InLinks (Platz 5)
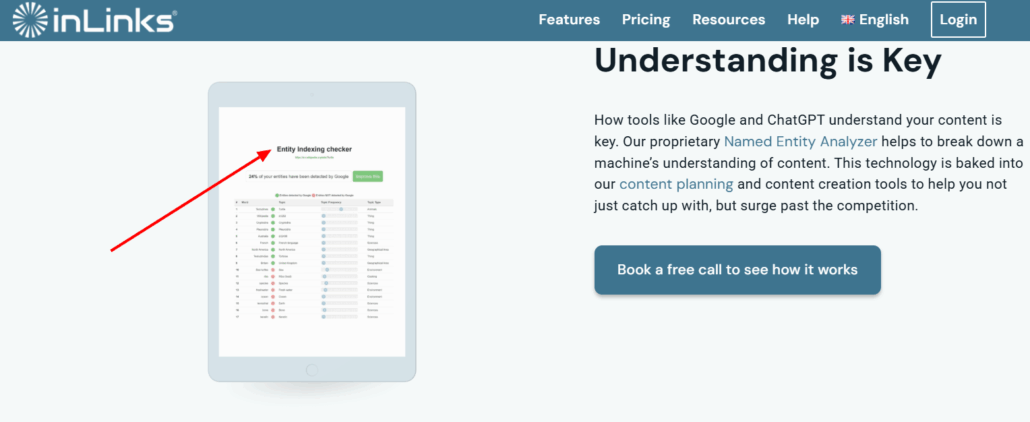
- Beschreibung des Tools: NLP-Algorithmus, der Seiten analysiert, um benannte Entitäten automatisch zu extrahieren und einen eigenen Knowledge Graph aufzubauen
- Funktion: Tool, bei dem man eine URL einreicht, um zu sehen, „welche benannten Entitäten Google erkannt hat“
- Fazit: InLinks ist ein integriertes und automatisiertes Entity-SEO-Tool
Yext (Platz 4)
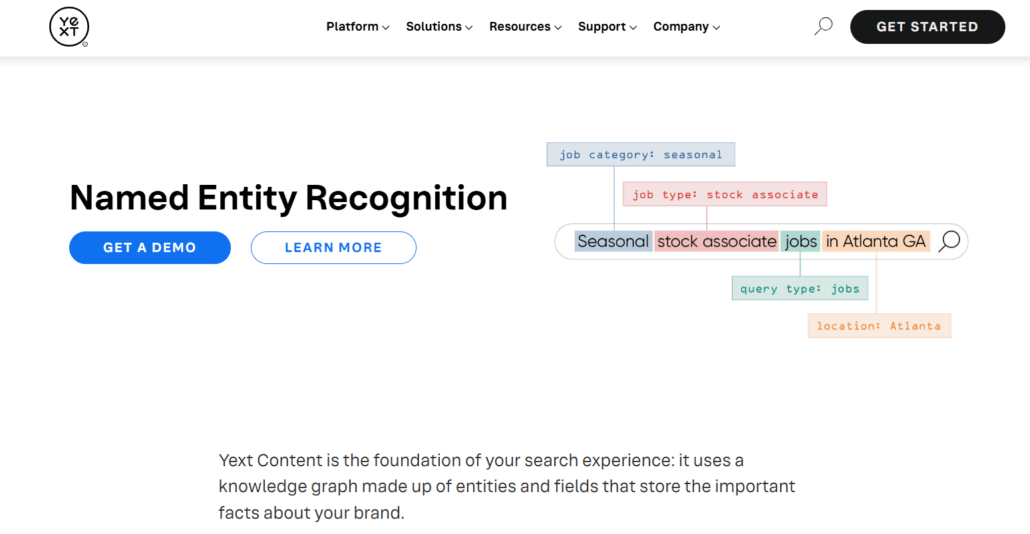
- Beschreibung des Tools: Integrierte Named Entity Recognition (NER), die Wörter erkennt und Entitätstypen zuordnet
- Funktion: Anpassbarer Knowledge Graph mit flexiblen Entitäten und komplexen Beziehungen
- Fazit: Yext ist tatsächlich ein integriertes und automatisiertes Entity-SEO-Tool
WordLift (Platz 10)
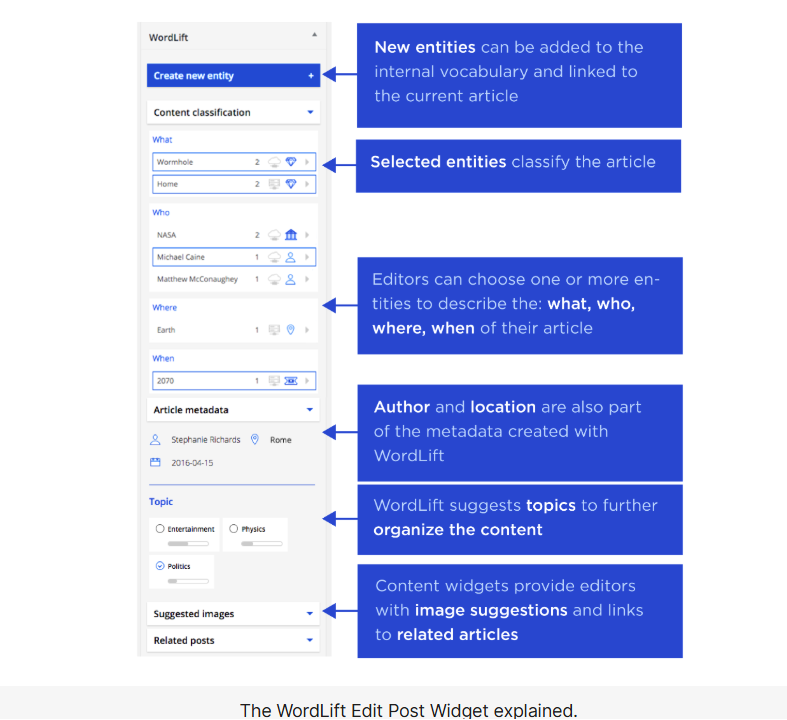
- Beschreibung des Tools: WordPress-Plugin, spezialisiert auf Entity Linking und semantische SEO
- Funktion: Halbautomatische Anbindung an die Datenbanken von Wikidata/Wikipedia, Erzeugung von Schema-Markup auf Basis von Entitäten
- Fazit: WordLift ist ein halbautomatisches Entity-SEO-Tool
❌ Das Tool mit mehrdeutigem Marketing (10 %)
SeoClarity (Platz 3)
Der Begriff der „benannten Entität“ wird, so wichtig er ist, von vielen Nutzern missverstanden, auch von Profis, die ihn oft mit „Keyword“ und „Themen“ verwechseln. Eine kunstvolle Unschärfe, die allerlei semantische Verrenkungen erlaubt, ob gewollt oder nicht …
Das zeigt zum Beispiel die Analyse dieser Website, hier zur Themenrecherche:

Wir stellen fest: Der Begriff Entität wird zwar erwähnt, aber die Liste, die die Analyse liefert, besteht aus Keywords (Plurale, Leerzeichen usw. berücksichtigt).
- Beschreibung des Tools: Erwähnt in seiner API „semantically related keywords, entities, and concepts“
- Funktion: Bietet „AI-driven entity groupings“ an, im Kern ist das aber Keyword-Clustering
- Problem: Mehrdeutiges Marketing, das die Verwirrung aufrechterhält
- Fazit: SeoClarity ist kein Entity-SEO-Tool, sondern ein Tool für die Keyword-Recherche.
❌ Die 6 völlig ungeeigneten Tools (60 %)
Schließlich gibt es die Websites, die gar nicht behaupten, ein Tool zur Entitätsanalyse anzubieten, und trotzdem auf der Liste gelandet sind. Der Fehler liegt beim LLM, das ihnen diese Eigenschaft zu Unrecht zugeschrieben hat, durch Halluzination oder überzogene Extrapolation.
Ahrefs (Platz 1)
- Beschreibung des Tools: Hervorragend bei Backlink-Analyse, Keyword-Recherche und technischem Audit
- Funktion: Keine Funktion zur Erkennung benannter Entitäten
- Paradox: Das eigene Glossar definiert Entity SEO, aber das Tool bietet es nicht an
- Fazit: Ahrefs ist kein Entity-SEO-Tool.
Semrush (Platz 2)
- Beschreibung des Tools: Umfassende SEO-Plattform, einfache semantische Analyse, Themenrecherche
- Funktion: Bildet Themencluster, erkennt aber keine benannten Entitäten im eigentlichen Sinn
- Verwirrung: Marketing, das semantische Analyse und Entitätserkennung vermischt
- Fazit: Semrush ist kein Entity-SEO-Tool.
Conductor (Platz 6)
- Beschreibung des Tools: Plattform für Content-Marketing und Enterprise-SEO
- Funktion: Keine spezifische Funktion für benannte Entitäten festgestellt
- Fazit: Conductor ist kein Entity-SEO-Tool.
BrightEdge (Platz 7)
- Beschreibung des Tools: Enterprise-SEO-Plattform mit KI zur Content-Optimierung
- Funktion: Keine spezifischen Funktionen zur Entitätserkennung
- Fazit: BrightEdge ist kein Entity-SEO-Tool.
SE Ranking (Platz 9)
- Beschreibung des Tools: Tool für Rank-Tracking und einfache SEO-Audits
- Funktion: Keine Funktion für benannte Entitäten
- Fazit: SE Ranking ist kein Entity-SEO-Tool.
Semrush Company (Platz 8)
- Beschreibung des Tools: Offenbar eine Dublette von Semrush (grober Fehler in der Antwort von ChatGPT)
- Status: Reiner Fehler des Algorithmus
- Fazit: Semrush ist kein Entity-SEO-Tool.
Warum macht ChatGPT bei Entity-SEO-Tools so viele Fehler?
Sind die Probleme diagnostiziert, bleibt die Frage nach ihren Ursachen. Das ist schwierig, weil die Funktionsweise des LLM undurchsichtig ist. Wir können uns daher nur auf Hypothesen stützen.
Die grundlegende Verwechslung: Keyword und Entität
Unsere Analyse legt die begriffliche Verwechslung offen, die im Kern des Problems steckt: Ein Keyword ist keine Entität. Diese Unterscheidung ist aber leider noch nicht klar, selbst für viele Fachleute nicht …
Die technischen Definitionen im Detail
Keyword : Ein Keyword ist eine rohe lexikalische Zeichenfolge, die aus einem Textkorpus extrahiert oder darin identifiziert wird, ohne eingehende semantische Einordnung in den Kontext. Es ist eine sprachliche Einheit an der Oberfläche:
- Art: Folge alphanumerischer Zeichen („Apple“, „SEO“, „Paris“)
- Verarbeitung: Statistische Analyse, Häufigkeitsanalyse und syntaktische Analyse
- Kontext: Beschränkt auf das analysierte Dokument bzw. Korpus
- Mehrdeutigkeit: Von Natur aus mehrdeutig (Paris = Stadt in Frankreich oder Texas, Vorname, Marke usw.)
- Erkennung: Suche nach Textübereinstimmung, einfache Indexierung
- Granularität: Sprachliche Oberfläche ohne Disambiguierung
Benannte Entität : Eine benannte Entität ist eine disambiguierte semantische Einheit, die für ein Objekt der realen Welt steht, mit strukturierten Attributen und kontextuellen Beziehungen. Das Konzept lässt sich so zusammenfassen:
- Art: Eindeutiges konzeptuelles Objekt mit dauerhafter Kennung (URI, Knowledge-Graph-ID), das sich meist mit einem Wikipedia-Artikel verknüpfen lässt
- Verarbeitung: Named Entity Recognition (NER) + Entity Linking + Einbindung in den Knowledge Graph
- Kontext: Angereichert durch relationale Metadaten (Geolokalisierung, Taxonomien, Ontologien)
- Disambiguierung: Aufgelöst durch Schema-Markup (PERSON, ORGANIZATION, LOCATION) und unterscheidende Attribute
- Erkennung: Semantische Suche, logische Schlussfolgerung, kontextbezogene Empfehlungen
- Granularität: Strukturierte Darstellung mit Eigenschaften und Beziehungen zwischen Entitäten
Der grundlegende Unterschied
| Aspekt | Keyword | Benannte Entität |
|---|---|---|
| Darstellung | Rohe Zeichenfolge | Strukturiertes semantisches Objekt |
| Identität | Mehrdeutig | Eindeutig und disambiguiert |
| Beziehungen | Keine | Beziehungsgraph |
| Entwicklung | Statisch | Dynamisch (Attribute werden aktualisiert) |
| Nutzung durch KI | Textabgleich | Semantisches Schlussfolgern |
Konkretes Beispiel:
- Keyword: „Apple“ → einfache Zeichenfolge aus 5 Zeichen, die eine Frucht, eine Elektronikmarke (Apple Inc.), ein Musikproduktionsunternehmen (Apple Corps) … sein kann
- Entität: http://dbpedia.org/resource/Apple_Inc. mit Eigenschaften (Apple Inc.: Gründer: Steve Jobs, Branche: Technologie, Hauptsitz: Cupertino, CA usw.) und Beziehungen zu anderen Entitäten im Knowledge Graph
Diese Unterscheidung ist entscheidend für moderne KI und die fortgeschrittene semantische Suche.
Wenn du mehr über Keywords, Entitäten und Themen erfahren möchtest, findest du hier einen ausführlichen Artikel dazu.
Wie stellt ChatGPT diese Desinformation her?
Hier ein bescheidener Erklärungsversuch, persönlich und subjektiv …
Annahme Nr. 1: Die Trainingsdaten sind von Anfang an verunreinigt
Das Problem beginnt weiter vorn: in den Daten, mit denen ChatGPT trainiert wurde, und in denen, die es bei der direkten Websuche findet. Tausende allgemeiner Artikel der Sorte „Top SEO tools“ verunreinigen das Web seit Jahren. Sie mischen munter alle Kategorien von Tools, ohne sie immer scharf voneinander trennen zu können. Solche Listen stammen oft von Bloggern, denen schnelles Veröffentlichen wichtiger ist als technische Expertise, und sie führen zuerst dieselben populären Plattformen auf, die sie dem Namen nach kennen. Dazu kommen Affiliate-Listen, die bewusst Tools bevorzugen, die die besten Provisionen oder die am leichtesten zugänglichen Partnerprogramme bieten, ohne Rücksicht darauf, wie gut sie technisch zum jeweiligen Zweck passen. Diese schädliche Verzerrung wird dadurch verschärft, dass in der Content-Marketing-Branche semantische SEO und Entity SEO verbreitet verwechselt werden: zwei unterschiedliche Konzepte, die viele Autoren in einen Topf werfen, weil sie die technischen Feinheiten nicht kennen.
Annahme Nr. 2: Verzerrung durch Häufigkeit im Algorithmus
Der Algorithmus von ChatGPT scheint teilweise nach dem Prinzip einer statistischen Gewichtung zu arbeiten: Je häufiger ein Element in den Trainingsdaten vorkommt, desto mehr Gewicht hat es in den Antworten. So erhalten Ahrefs und Semrush, die in etwa 90 % der allgemeinen SEO-Listen auftauchen, im Denken der KI ein enormes algorithmisches Gewicht, unabhängig davon, wie relevant sie für Entity SEO sind. InLinks dagegen ist zwar ein anerkannter Spezialist für Entity SEO, taucht aber in allgemeinen Webinhalten seltener auf und ist deshalb in den algorithmischen Berechnungen unterrepräsentiert. Diese Logik aus Popularität und Häufigkeit führt dazu, dass die KI dazu neigt, „Mainstream“-Tools gegenüber tatsächlicher technischer Relevanz zu bevorzugen. So entsteht ein Teufelskreis, in dem Sichtbarkeit im Marketing Vorrang vor spezialisierter Expertise hat.
Annahme Nr. 3: Algorithmische Synthese ohne Überprüfung
Anders, als man denken könnte, gibt ChatGPT nicht einfach eine bestehende Liste wieder, die es irgendwo im Web gefunden hat. Es nimmt eine komplexe algorithmische Synthese vor und setzt eine eigene Fassung neu zusammen, indem es die Elemente mischt, die in seinen Trainingsdaten und Online-Suchen am häufigsten genannt werden. Diese Neuzusammensetzung geschieht ohne jede technische Prüfung dessen, was die genannten Tools tatsächlich können. Der Algorithmus hat keinen Mechanismus, um zwischen Marketingaussagen (was Tools angeblich können) und tatsächlichen technischen Fähigkeiten (was sie wirklich können) zu unterscheiden. Er fasst einfach die häufigsten Nennungen zusammen und präsentiert sie als stimmige Empfehlung. So entsteht eine neue Form algorithmischer „Wahrheit“, losgelöst von der technischen Realität.
Annahme Nr. 4: Halluzination durch logische Extrapolation
Am tückischsten ist die Halluzination durch Extrapolation. Die KI stellt logische Verbindungen her, die vernünftig wirken, technisch aber falsch sind: „Wenn Ahrefs hervorragend für SEO ist und wir über Entity SEO sprechen, dann muss Ahrefs auch gut für Entity SEO sein.“ Diese fehlerhafte Logik bringt ChatGPT dazu, „Wahrheiten“ zu erzeugen, die in seinem Denksystem stimmig, von der technischen Realität aber losgelöst sind. Der Algorithmus erfindet so Fähigkeiten oder Spezialisierungen, die es nicht gibt, und stützt sich dabei auf Assoziationen statt auf überprüfbare Fakten. All das wird dann mit einer künstlichen Autorität vorgetragen, die die Unsicherheit dieser Extrapolationen vollständig verdeckt. Es entsteht der Eindruck von Expertise, obwohl es sich in Wahrheit um eine ungefähre und weitgehend fragwürdige algorithmische Konstruktion handelt.
Die schädlichen Folgen
Für spezialisierte Marken (InLinks, WordLift, Yext)
Algorithmische Unsichtbarkeit: Die fortgeschrittenen technischen Lösungen dieser Unternehmen, die sich auf die Extraktion benannter Entitäten spezialisiert haben, gehen im Rauschen allgemeiner KI-Empfehlungen unter.
Unfairer Wettbewerb: Diese Marken führen einen ungleichen Kampf gegen die kolossalen Marketingbudgets allgemeiner Plattformen, die die Trainingsdaten sättigen. Während InLinks ausgefeilte Funktionen für die semantische Analyse entwickelt, investiert Ahrefs massiv in Content-Marketing. So entsteht ein künstlicher Wettbewerbsvorteil, der mit dem technischen Wert nichts zu tun hat.
Verwässerte Expertise: Jahre spezialisierter Forschung und Entwicklung zu Knowledge Graphs oder zur Entitätsextraktion schrumpfen in automatisierten Vergleichen auf ein paar allgemeine Zeilen zusammen. Diese ungefähre algorithmische Synthese macht aus präzisen technischen Innovationen austauschbare Massenware und zerstört die Differenzierung, die ihre Existenz rechtfertigt.
Für Unternehmen, die die Tools nutzen
Geldverlust: Unternehmen abonnieren ungeeignete oder nicht existierende Tools. Das führt zu Fehlinvestitionen, die die erwarteten Ergebnisse nicht bringen können.
Systemischer Zeitverlust: Die Zeit, die mit ungeeigneten Tools verloren geht, fehlt für die Einführung wirklich passender Tools.
Technische Ernüchterung: Unternehmen könnten vorschnell zu dem Schluss kommen, dass „Entity SEO nicht funktioniert“. Diese Ernüchterung könnte dazu führen, dass tatsächlich wirksame Technologien pauschal abgelehnt werden, und anhaltende Skepsis gegenüber tragfähigen technischen Ansätzen erzeugen.
Gefährliche kognitive Abhängigkeit: Wer technische Entscheidungen nach und nach an unzuverlässige Algorithmen delegiert, lässt das kritische Urteilsvermögen verkümmern. Fachleute könnten blindes Vertrauen in Systeme entwickeln, deren Funktionsweise und Grenzen sie weder beherrschen noch verstehen. Falls das nicht schon geschehen ist …
Für das Web insgesamt
Aktive Erzeugung von Desinformation: LLMs drohen irgendwann durch algorithmische Neukombination aktiv neue Formen technischer Desinformation zu erzeugen: Empfehlungen, die es in den ursprünglichen Quellen nie gab. Die Maschine wird zur Urheberin falscher Informationen, statt bestehende Fehler bloß zu verstärken.
Exponentielle Verunreinigung der Informationen: Nimmt man sie für bare Münze, könnte jede falsche Antwort eines LLM Tausende Entscheidungen oder Inhalte beeinflussen, die ihrerseits wieder neue Entscheidungen oder Inhalte auf Grundlage dieser Fehler hervorbringen. Diese Vervielfachung erzeugt einen Schneeballeffekt, bei dem sich der Fehler exponentiell ausbreitet und jeder Durchlauf die verunreinigte Informationsfläche vergrößert.
Erzwungene Vereinheitlichung: KI könnte „populäre“ Tools, die in ihren Daten überrepräsentiert sind, mechanisch bevorzugen und damit spezialisierte, weniger gut dokumentierte Innovationen ersticken. Diese Logik der Popularität lässt technische Innovation insgesamt verarmen, zugunsten eines vereinheitlichten Marktes.
Warum technisches Fact-Checking nötig ist
Für Fachleute ist es unerlässlich, die tatsächlichen technischen Fähigkeiten von Tools systematisch zu prüfen, bevor sie sie einsetzen, auch wenn das natürlich schwierig ist. Denn Marketingversprechen entsprechen nicht immer der Realität im Betrieb. Zu dieser Wachsamkeit gehört, KI-Empfehlungen nie als Wahrheit hinzunehmen, weil diese Systeme Fehler aus ihren Trainingsdaten oder aus dem Web wiedergeben und verstärken können. Deshalb sollte man konkreten Funktionstests den Vorzug geben, statt Marketingbeschreibungen blind zu vertrauen. Diese neigen oft dazu, die tatsächliche Leistung zu überschätzen und technische Grenzen der angebotenen Lösungen kleinzureden, aus Unwissenheit oder aus Gewinninteresse.
Fazit: Wenn KI ihre eigenen „Wahrheiten“ errichtet, wo stehen wir dann?
Diese kleine Analyse einer ChatGPT-Antwort zeigt ein beunruhigendes Phänomen: Neue falsche technische Informationen entstehen rein algorithmisch.
Ein aufschlussreicher Befund
70 % der Tools erweisen sich als ungeeignet, in einer Empfehlung, die mit Autorität vorgetragen wird. ChatGPT hat keinen bestehenden Fehler wiedergegeben: Es hat Tausende verzerrter Quellen zu seiner eigenen Desinformation zusammengefasst.
Diese aktive Erzeugung algorithmischer „Wahrheiten“ ist gefährlicher als die bloße Weitergabe von Fehlern, denn:
- Sie erzeugt die Illusion von Expertise, indem sie Ungefähres zusammenträgt
- Sie schafft einen künstlichen Konsens, wo es unter echten Fachleuten keinen gibt
- Sie beeinflusst Entscheidungen in großem Umfang, ohne dass sich die Quellen nachvollziehen lassen
- Sie lässt Unternehmen mit echter Expertise gegen andere antreten, die … keine haben.
Die zivilisatorische Dimension
In einer Welt, in der KI zur Instanz wird, die technische Lösungen empfiehlt, erleben wir eine stille Verlagerung der Empfehlungsmacht: von menschlichen Experten (oder Pseudo-Experten) zu Algorithmen, die ihre eigenen „Wahrheiten“ ohne Qualitätskontrolle herstellen.
Hinter dieser harmlos wirkenden Liste steckt eine große Frage: Wer kontrolliert im KI-Zeitalter, wie technisches Wissen entsteht? Algorithmen oder menschliche Expertise?
Mit diesem Experiment haben wir den sachlichen Beleg dafür, dass KI Empfehlungen fabrizieren kann, die zu 70 % falsch sind, und sie dabei mit einer Autorität vorträgt, die vom Nachprüfen abhält.
Und deine Expertise: Wie nehmen LLMs sie wahr?
Mit unserem Tool Waikay kannst du das gründlich prüfen: What AI Knows About You?


